
判题沙箱指的是专门运行给定代码的一个应用程序。外部程序需要使用 HTTP 协议与判题沙箱进行通信。
它负责接收用户编写的函数、判题模板、输入输出数据、编程语言类型、内存限制、时间限制等等参数,最终判题沙箱进程通过一个子协程来对本次输入进行判题操作。
沙箱进程本身部署在 Docker 容器中,具有天生的隔离性,保证了服务器的安全性。
一句话总结判题沙箱的作用:运行用户提交的代码,判断正误并将结果返回。
- Goroutine(Go 语言轻量级并发协程)
- Gin(Go 语言轻量级兼高性能 Web 后端框架)
- Docker(容器隔离技术)
运行代码沙箱:docker run -d -p 8080:8080 镜像ID
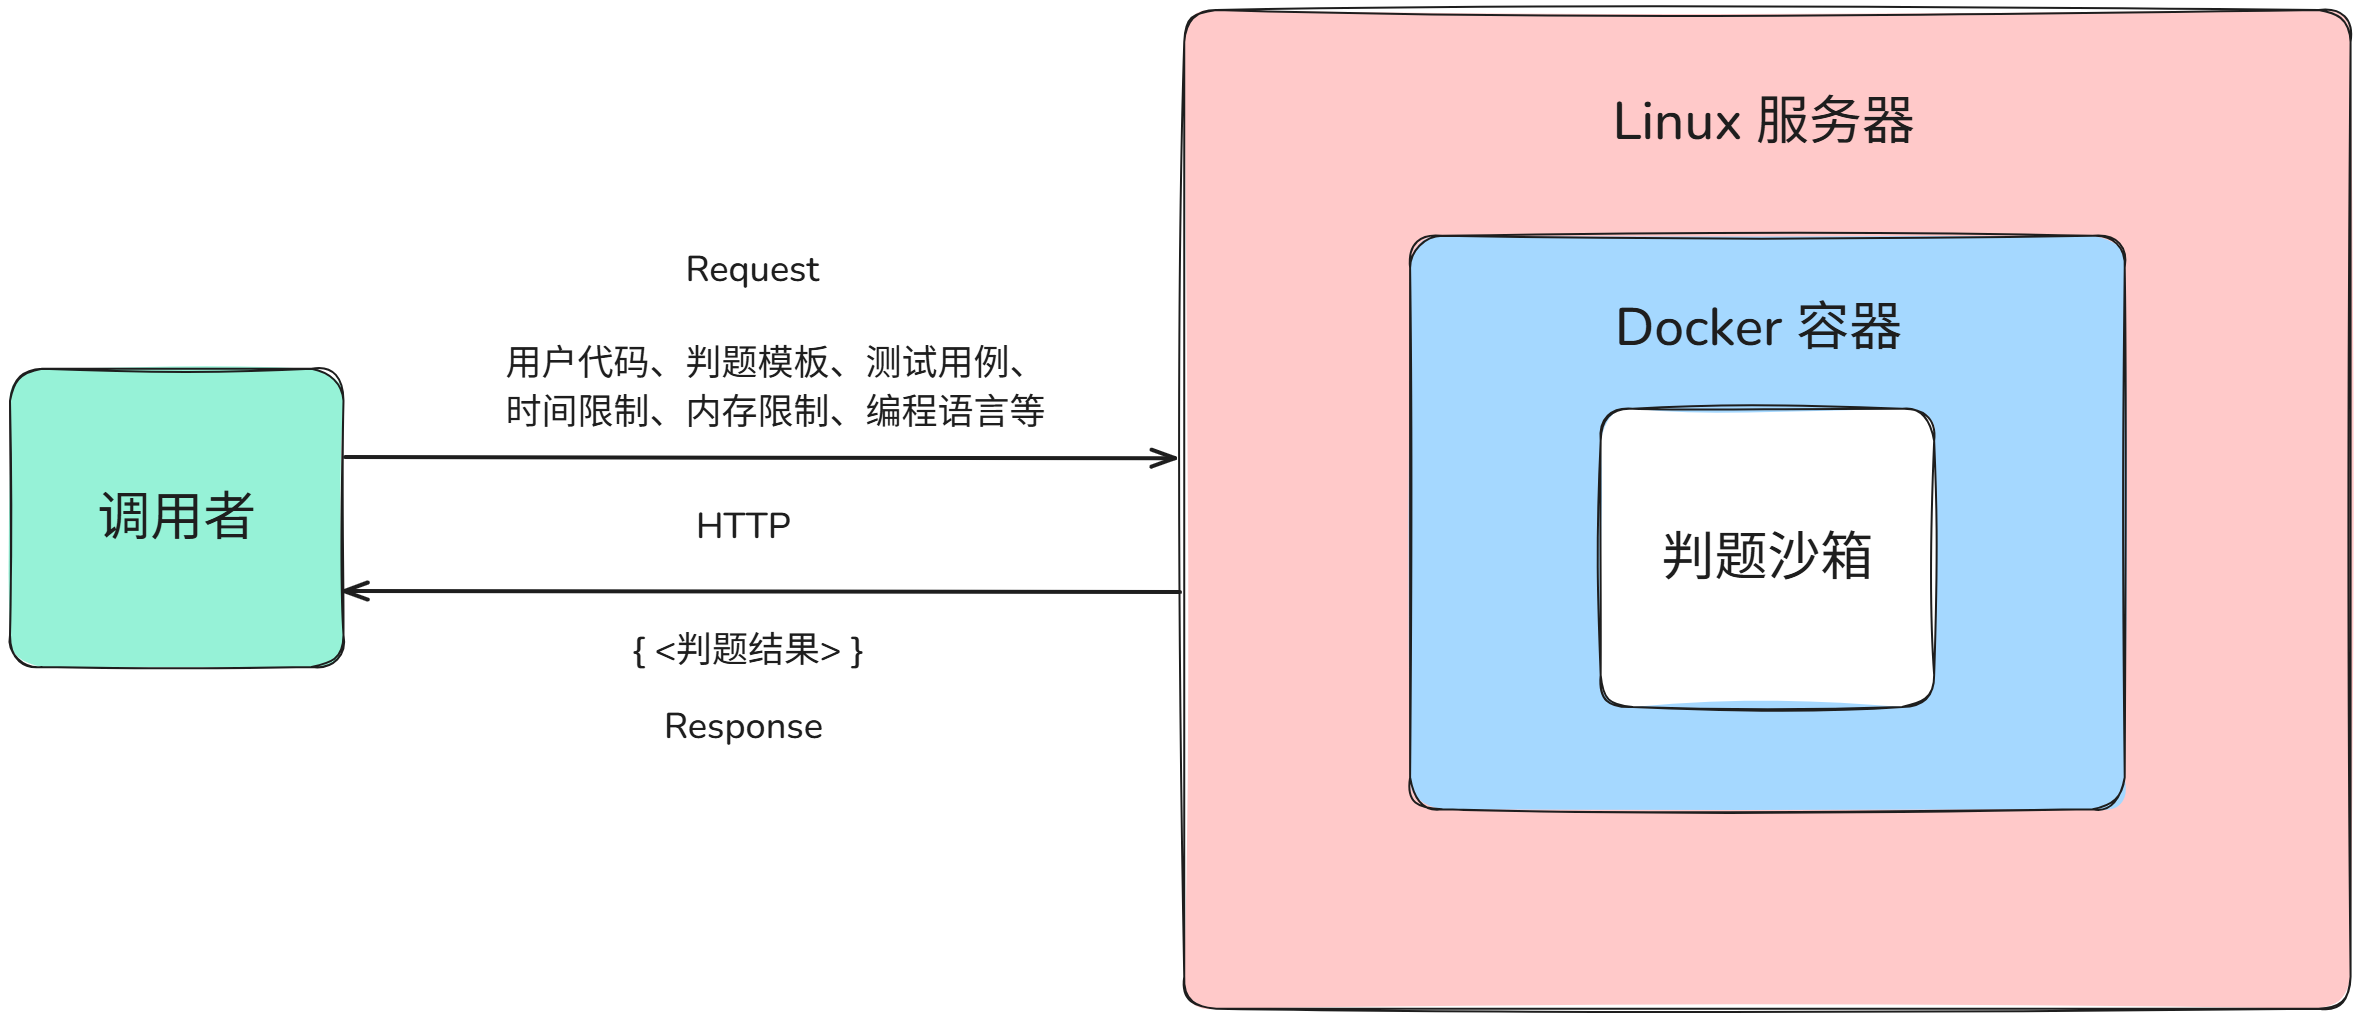
图 5-1 沙箱调用过程
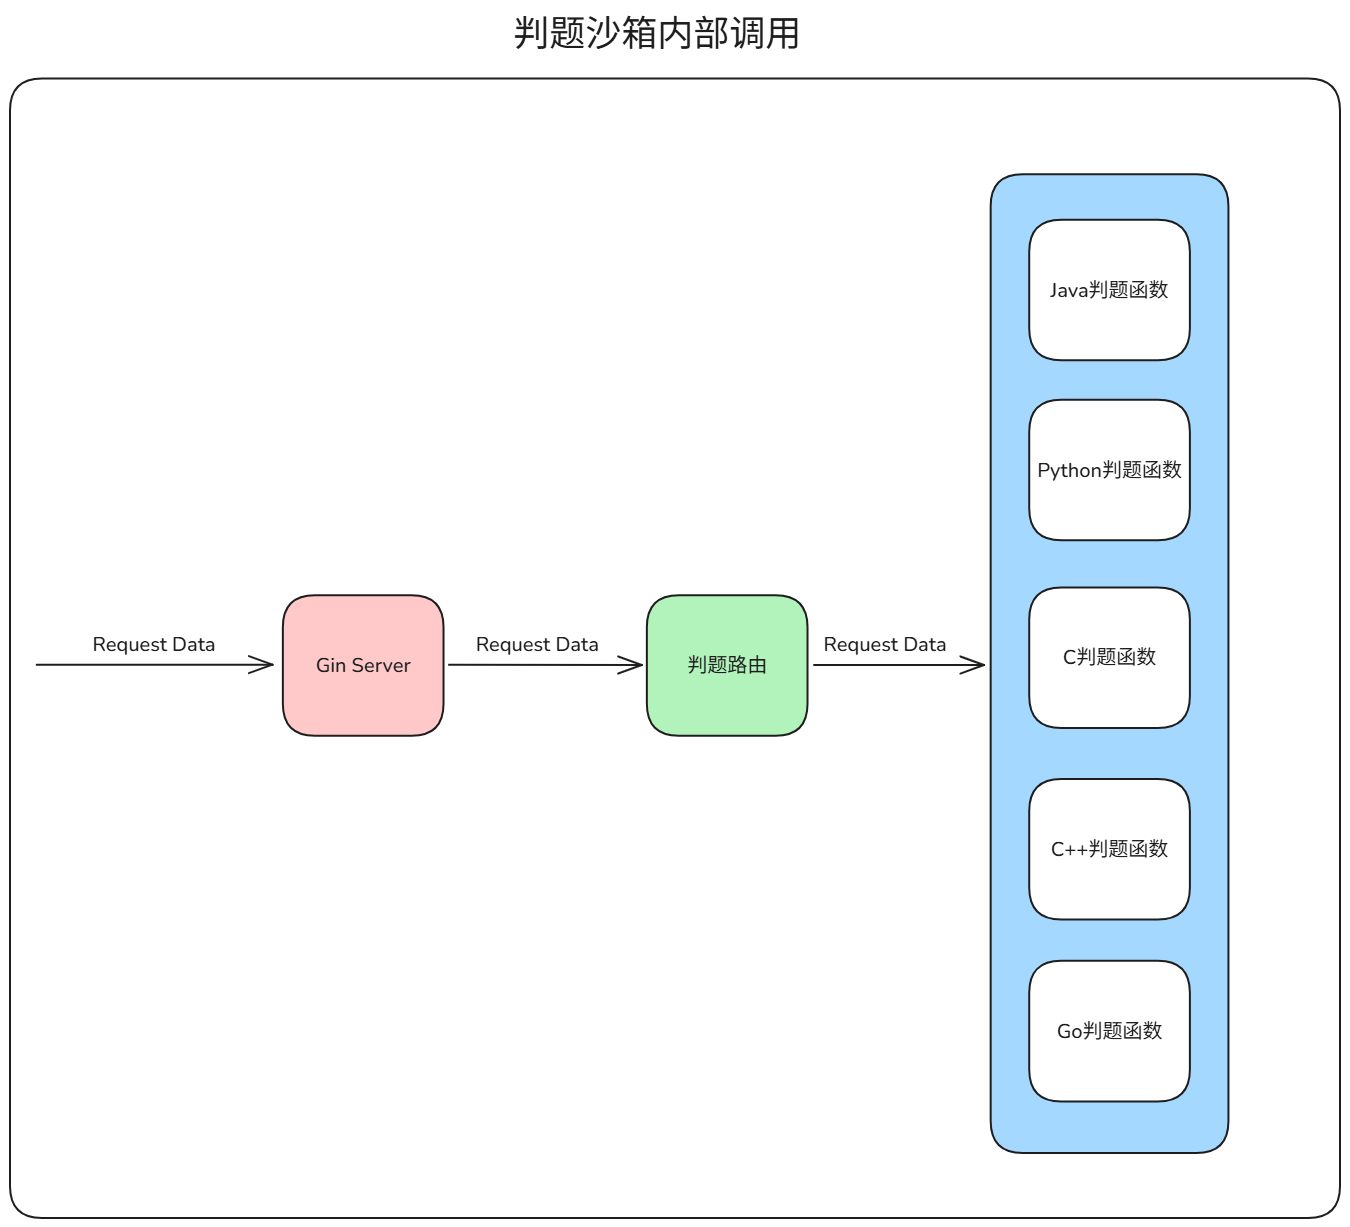
图 5-2 沙箱内部调用过程
import httpx

url = "http://localhost:8080/sandbox/judgement"
data = {
    "language": "编程语言名称",  # python | java | c | cpp | go
    "question_id": 1,  # 当前题目对应的 ID
    "judge_template": "该编程语言对应的判题模板代码",
    "solution_code": "用户编写的代码",
    "tests": [
        {"test_id": 1, "input_output": "输入输出1"},
        {"test_id": 2, "input_output": "输入输出2"},
        ...
    ],
    "time_limit": "时间限制",
    "memory_limit": "内存限制",
    "user_id": "用户ID"
}
response = httpx.post(url, json=data){
"code": 200, /* 200表示判题成功(不代表通过测试用例),422表示输入数据有问题 */
"message": "OK | 其他消息",
"results": [
{
"tets_id": 1,
"status": 1,
"result": "判题结果(OK | ErrorMessage)",
"answer": "解题函数的输出(字符串)",
"criterion": "正确的输出(字符串)",
"time_consumed": "运行该测试用例消耗的时间",
"memory_consumed": "运行该测试用例消耗的内存",
"is_success": true /* 是否通过该测试用例 */
},
...
]
}import httpx
language = "python"
question_id = 1
judge_template = """
class Runner(BaseRunner):
def process_input_output(self):
_ = int(input())
nums = list(map(int, input().split()))
criterion = int(input())
self.inputs = (nums,)
self.outputs = (criterion,)
def check_answer(self, answer):
criterion = self.outputs[0]
return criterion == answer, criterion
"""
solution_code = """
def solution(nums: list[int]) -> int:
return sum(nums)
"""
tests = [
{
"test_id": 1,
"input_output": "3\n1 2 3\n6"
},
{
"test_id": 2,
"input_output": "2\n10 11\n22"
}
]
time_limit = 1000 * 20 # 单位是ms
memory_limit = 500 # 单位是MB
data = {
"language": language,
"question_id": question_id,
"judge_template": judge_template,
"solution_code": solution_code,
"tests": tests,
"timel_limit": time_limit,
"memory_limit": memory_limit,
"user_id": "2025012849102"
}
url = "http://localhost:8080/judgement"
response = httpx.post(url, json=data){
"code": 200,
"message": "OK",
"results": [
{
"tets_id": 1,
"status": 1,
"result": "OK",
"answer": "6",
"criterion": "6",
"time_consumed": 212,
"memory_consumed": 0.1,
"is_success": true
},
{
"tets_id": 2,
"status": 1,
"result": "OK",
"answer": "22",
"criterion": "22",
"time_consumed": 234,
"memory_consumed": 0.3,
"is_success": true
},
]
}为了适应所有的编程语言,所有的输入和输出均保存在同一个字符串中,并且使用最原始的方式保存数据。
例如真实的输入输出:
3
1 2 3
6
实际保存的输入输出:
"3\n1 2 3\n6"
这样的方式可以适应所有的编程语言,因为几乎所有的编程语言都支持从标准输入流中读取数据,当有了这些数据之后,相应的编程语言可以根据它的特征进一步构造好数据类型,再将构造好的输入数据传递给用户编写的解题函数,然后捕获这个函数的输出,最后再用从输入流中读取的正确输出与该函数的输出进行比对。最后由代码沙箱来捕获判题结果并返回给调用者。
当拿到判题模板和解题函数以后,需要将这两份代码前保存在/tmp目录下,这样就会比较方便运行代码。
除此之外,调用者还会将题目ID和用户ID传过来,因此可以使用这两个值来处理目录冲突的问题。
期望的目录格式:/tmp/<question_id>/<user_id>/<language>。
假设接收到数据是这样的:
{
  "language": "python",
  "user_id": "2025012849102",
  "question_id": 1,
  ...
}那么这时应该先创建一个目录:/tmp/1/2025012849102/python。
然后在这个目录的内部创建相关的代码文件。
例如:
/tmp/1/2025012849102/python/solution_code.py/tmp/1/2025012849102/python/main.py
最后由 Go 语言调用 Python 解释器并将输入输出数据传入主函数中。
echo -e '<输入输出文本>' | python3 /tmp/1/2025012849102/python/main.py判题模板的编写需要根据每个编程语言的特性来编写。目的是为了最大程度的减少判题模板的重复代码。
从绝大多数情况来看,每一题的判题模板的编写几乎只有输入输出结果的捕获还有验证判题结果的代码不一样,其他的代码基本上都是一致的。因此需要发挥每个编程语言的特性,使得判题模板的重复代码量降低到最小。
使用 Python 面向对象编程的特性,可以降低判题模板的代码量。
在判题沙箱的内部,会提前保存好一个名为runner.py的模块,这个模块提供了一系列用于对 Python 语言判题的代码(代码位于internal/sandbox/python/runner.py目录下):
import json
import os
import sys
import traceback
import signal
import resource
import time
from typing import Any, Sequence
from contextlib import contextmanager


def parse_exception() -> str:
    exc_type, exc_value, exc_tb = sys.exc_info()
    tb_list = traceback.extract_tb(exc_tb)
    last_frame = tb_list[-1]

    error_msg = f"{exc_type.__name__}: {exc_value}"
    code_line = last_frame.line.strip() if last_frame.line else ""

    return json.dumps({
        "error_msg": error_msg,
        "error_lineno": last_frame.lineno,
        "error_colno": last_frame.colno,
        "error_line": code_line
    })


class ResourceLimiter:
    """
    资源使用限制器

    Args:
        time_limit: 最大执行时间(毫秒)
        memory_limit: 最大内存使用量(MB)
    """
    def __init__(self, time_limit: int, memory_limit: float):
        self.time_limit = int(time_limit / 1000)  # 毫秒 -> 秒
        self.memory_limit = int(memory_limit * 1024 * 1024)
        self.start_time = None
        self.start_memory = None
        self.end_time = None
        self.end_memory = None

    @contextmanager
    def limit_resources(self):
        """上下文管理器,用于限制资源并跟踪使用情况"""
        # 记录开始指标
        self.start_time = time.time()
        self.start_memory = self._get_memory_usage()

        # 设置时间限制
        signal.signal(signal.SIGALRM, self._timeout_handler)
        signal.alarm(self.time_limit)

        # 设置内存限制(虚拟内存限制)
        resource.setrlimit(resource.RLIMIT_AS, (self.memory_limit, self.memory_limit))

        try:
            yield
        finally:
            # 记录结束指标
            self.end_time = time.time()
            self.end_memory = self._get_memory_usage()

            # 取消定时器
            signal.alarm(0)

    def _timeout_handler(self, signum, frame):
        """处理超时信号"""
        raise TimeoutError

    def _get_memory_usage(self):
        """
        获取当前进程内存使用量(字节)
        通过读取 Linux /proc 文件系统获取准确的内存信息
        """
        try:
            # 读取当前进程的内存信息
            with open(f'/proc/{os.getpid()}/status', 'r') as f:
                for line in f:
                    if line.startswith('VmRSS:'):  # 实际使用的物理内存
                        # 格式: VmRSS: 12345 kB
                        return int(line.split()[1])
        except (IOError, ValueError, IndexError):
            # 如果无法读取 /proc 文件,使用resource模块作为备选
            usage = resource.getrusage(resource.RUSAGE_SELF)
            return usage.ru_maxrss

    def get_execution_stats(self):
        """
        返回资源使用量

        Returns:
            time_consumed: 时间消耗(毫秒)
            memory_consumed: 内存消耗(MB)
        """
        if self.start_time is None or self.end_time is None:
            return None

        time_consumed = int((self.end_time - self.start_time) * 1000)  # 转换为毫秒
        memory_consumed = round((self.end_memory - self.start_memory) / 1024, 2)  # 转换为MB

        return time_consumed, memory_consumed


class BaseRunner:
    def __init__(self):
        self.inputs: Sequence[Any] = None
        self.outputs: Sequence[Any] = None
        self.answer: Any | Sequence[Any] = None
        self.time_limit: int = None
        self.memory_limit: float = None

    def process_time_memory_limit(self):
        limits_input = input().split()
        self.time_limit = int(limits_input[0])
        self.memory_limit = float(limits_input[1])

    def process_input_output(self):
        """
        从一个标准的字符串输入中处理输入和输出结果。

        处理完毕以后需要为 self.inputs, self.outputs 这两个属性赋值。
        """

    def check_answer(self, answer: Any) -> bool:
        """
        检查解题函数的运行结果。

        检查完毕以后需要将检查结果和标准结果返回

        Args:
            answer: 用户解题函数的返回值

        Returns:
            is_success: 解题函数的返回值是否与预期值相同
            criterion: 正确的结果
        """

    def process_stdin(self):
        """处理标准输入流数据"""
        self.process_time_memory_limit()
        self.process_input_output()

    def run(self):
        self.process_stdin()
        limiter = ResourceLimiter(self.time_limit, self.memory_limit)

        status = 1
        result = "OK"
        answer = criterion = None
        is_success = False
        time_consumed, memory_consumed = -1, -1

        with limiter.limit_resources():
            try:
                from solution_code import solution

                answer = solution(*self.inputs)
            except TimeoutError:
                result = "Time Limit Exceeded"
                status = -3
            except MemoryError:
                result = "Memory Limit Exceeded"
                status = -4
            except Exception as _:
                result = parse_exception()
                status = -1

        if status == 1:
            is_success, criterion = self.check_answer(answer)
            time_consumed, memory_consumed = limiter.get_execution_stats()

        run_result = {
            "status": status,
            "result": result,
            "is_success": is_success,
            "answer": str(answer),
            "criterion": str(criterion),
            "time_consumed": time_consumed,
            "memory_consumed": memory_consumed
        }

print("<SandboxOutput-Start-" + json.dumps(run_result) + "-SandboxOutput-End>")对于每个题目的判题模板,你需要定义一个Runner类并继承BaseRunner,然后重写process_input_output和check_answer这两个核心钩子函数。
这两个方法被调用的顺序是:
process_input_output->check_answer。
以下是一个判题模板的编写示例:
class Runner(BaseRunner):
    def process_input_output(self):
        # 从标准输入流中读取输入输出数据并解析它们
        _ = int(input())
        nums = list(map(int, input().split()))
        criterion = int(input())
        # 保存解析好的输入输出结果(注意需要元组类型)
        self.inputs = (nums,)
        self.outputs = (criterion,)

    def check_answer(self, answer):
        criterion = self.outputs[0]  # 从之前保存的outputs属性中读取正确输出
return criterion == answer, criterion # 返回判题结果与正确结果在编写判题模板的时候,你可以假定BaseRunner这个类是存在的,因为判题沙箱在运行你的判题模板时会自动导入BaseRunner这个类。
对于process_input_output这个方法,你需要编写从标准输入流中读取输入输出的代码,并将它们构造为一个符合该题的数据类型,然后使用inputs和outputs这两个属性来分别保存输入和输出,这两个属性的类型都是元组类型。当运行用户的解题函数时,BaseRunner类会将inputs属性的值解包并按位置传参的方式传入到用户的解题函数中。
而check_answer这个方法是专门用于编写用户的解题函数输出是否与预期输出结果一致的判题代码,你需要按照题目的要求检查用户的输出是否符合标准结果,最后将判题结果与正确结果返回。
所以最终需要编写的判题模板代码只有类似上述代码,并且后端数据库也只需要保存上述的判题模板代码,其他的任务都由runner.py模块来完成。
在运行你的判题模板时,判题沙箱会进行以下 3 件事情:
- 重新构造你的判题模板并将它写入
**main.py**文件中。
你的判题模板最终会被判题沙箱重构成以下的样子:
from runner import BaseRunner

class Runner(BaseRunner):
    def process_input_output(self):
        _ = int(input())
        nums = list(map(int, input().split()))
        criterion = int(input())
        self.inputs = (nums,)
        self.outputs = (criterion,)

    def check_answer(self, answer):
        criterion = self.outputs[0]
        return criterion == answer, criterion

Runner().run()
可以看到上述的代码除了你编写的判题模板以外,只额外多出了两行代码(标绿色背景的代码)。
第一行代码是为了补全判题模板在判题时所缺失的函数和类。最后一行代码是调用你的Runner类,也就是执行判题逻辑。
然后系统会将上述内容写入main.py文件中,最终系统会直接运行这个文件以执行判题逻辑。
- 创建
solution_code.py文件。
将用户编写的所有代码都保存到这个文件中,后续在判题时会尝试导入这个模块代码。
- 将
runner.py、main.py、solution_code.py这 3 个文件全部保存到同一个目录下。
当这些文件被拷贝到同一个目录以后,就可以相互导入了,最后系统运行main.py文件,与此同时将测试用例对应的输入输出数据重定向到这个文件中,然后就是后续的判题的流程了……
Go 语言会捕获对应判题模板的输出结果,并将结果转换成一个统一的格式。
对于所有的测试用例,都会返回下面的结果(JSON字符串):
{
  "test_id": 1,
  "status": 1,
  "result": "OK | ErrorMessage",
  "is_success": true,
  "answer": "解题函数的输出,结果会被转换成字符串类型",
  "criterion": "正确的输出,结果会被转换成字符串类型",
  "time_consumed": "运行该测试用例消耗的时间",
  "memory_consumed": "运行该测试用例消耗的内存",
}
表 5-1 测试用例响应结果解释
| 字段名 | 字段类型 | 字段名解释 |
|---|---|---|
| test_id | 整型 | 该测试用例在数据库中的 ID 值。 |
| status | 整型 | 系统判题状态。 判题成功(成功不代表结果正确,只是判题过程中没有发生报错)时为 1;当用户的解题代码发生异常时该值为 -1;未捕获到的异常类型则该值为 -2;代码运行超时时为-3;超出内存限制时为-4。 |
| result | 字符串 | 判题结果。 判题成功时返回 "OK";判题失败时会返回错误消息。如果此时的status值为 -1,则会返回经过敏感词过滤后的异常结果,结果的类型是JSON字符串(真实内容以实际返回为准),后端可以直接将这个结果可以返回到客户端中;如果status的值为 -2,此时返回的异常包含系统中的敏感数据(例如系统路径等等敏感信息),此时的报错不能直接返回给客户端,这时后端应该将这个错误替换成其他结果,例如“系统运行异常”等等错误信息。 |
| is_success | 布尔型 | 用户解题函数的输出是否与预期结果一致。 |
| answer | 字符串 | 用户解题函数的输出结果。 |
| criterion | 字符串 | 预期输出结果。 |
| time_consumed | 整型 | 运行该测试用例花费的时间。代码运行失败时该值为 -1。 |
| memory_consumed | 浮点型 | 运行该测试用例消耗的内存。代码运行失败时该值为 -1。 |
- 用户解题函数错误
- 判题过程中未捕获的错误
- 代码运行超时
这个任务由判题模板来限制是最合适的,并且限制粒度需要控制到函数级别。
也就是说需要对solution进行单独限制,由相应的编程语言来限制。
如果是 Python 这种导入函数时整个模块都会被的运行的,还要小心用户在模块层运行恶意代码,因此对于内存和时间限制可能需要对整个模块做限制。
假设用户编写的solution代码是:
def solution():
    while True:
        pass  # 模拟长时间/高内存操作
或者用户提交的 Python 解题代码在整个模块下的代码:
input()  # 这里也会阻塞代码
def solution():
    pass
以下是各个编程语言的内存时间限制示例:
class ResourceLimiter:
    """
    资源使用限制器

    Args:
        time_limit: 最大执行时间(毫秒)
        memory_limit: 最大内存使用量(MB)
    """
    def __init__(self, time_limit: int, memory_limit: float):
        self.time_limit = int(time_limit / 1000)  # 毫秒 -> 秒
        self.memory_limit = int(memory_limit * 1024 * 1024)
        self.start_time = None
        self.start_memory = None
        self.end_time = None
        self.end_memory = None

    @contextmanager
    def limit_resources(self):
        """上下文管理器,用于限制资源并跟踪使用情况"""
        # 记录开始指标
        self.start_time = time.time()
        self.start_memory = self._get_memory_usage()

        # 设置时间限制
        signal.signal(signal.SIGALRM, self._timeout_handler)
        signal.alarm(self.time_limit)

        # 设置内存限制(虚拟内存限制)
        resource.setrlimit(resource.RLIMIT_AS, (self.memory_limit, self.memory_limit))

        try:
            yield
        finally:
            # 记录结束指标
            self.end_time = time.time()
            self.end_memory = self._get_memory_usage()

            # 取消定时器
            signal.alarm(0)

    def _timeout_handler(self, signum, frame):
        """处理超时信号"""
        raise TimeoutError

    def _get_memory_usage(self):
        """
        获取当前进程内存使用量(字节)
        通过读取 Linux /proc 文件系统获取准确的内存信息
        """
        try:
            # 读取当前进程的内存信息
            with open(f'/proc/{os.getpid()}/status', 'r') as f:
                for line in f:
                    if line.startswith('VmRSS:'):  # 实际使用的物理内存
                        # 格式: VmRSS: 12345 kB
                        return int(line.split()[1])
        except (IOError, ValueError, IndexError):
            # 如果无法读取 /proc 文件,使用resource模块作为备选
            usage = resource.getrusage(resource.RUSAGE_SELF)
            return usage.ru_maxrss

    def get_execution_stats(self):
        """
        返回资源使用量

        Returns:
            time_consumed: 时间消耗(毫秒)
            memory_consumed: 内存消耗(MB)
        """
        if self.start_time is None or self.end_time is None:
            return None

        time_consumed = int((self.end_time - self.start_time) * 1000)  # 转换为毫秒
        memory_consumed = round((self.end_memory - self.start_memory) / 1024, 2)  # 转换为MB

        return time_consumed, memory_consumed
在从导入用户的解题函数代码的那句话开始,就需要对资源做出限制了:
limiter = ResourceLimiter(*args, **kwargs)
with limiter.limit_resources():
    try:
        # 将用户所有的代码包含在异常处理块中
        from solution_code import solution
        solution()
    except TimeoutError:
        pass  # 处理超时异常
    except MemoryError:
        pass  # 处理内存超出限制异常
    except Exception:
        pass  # 处理其他异常